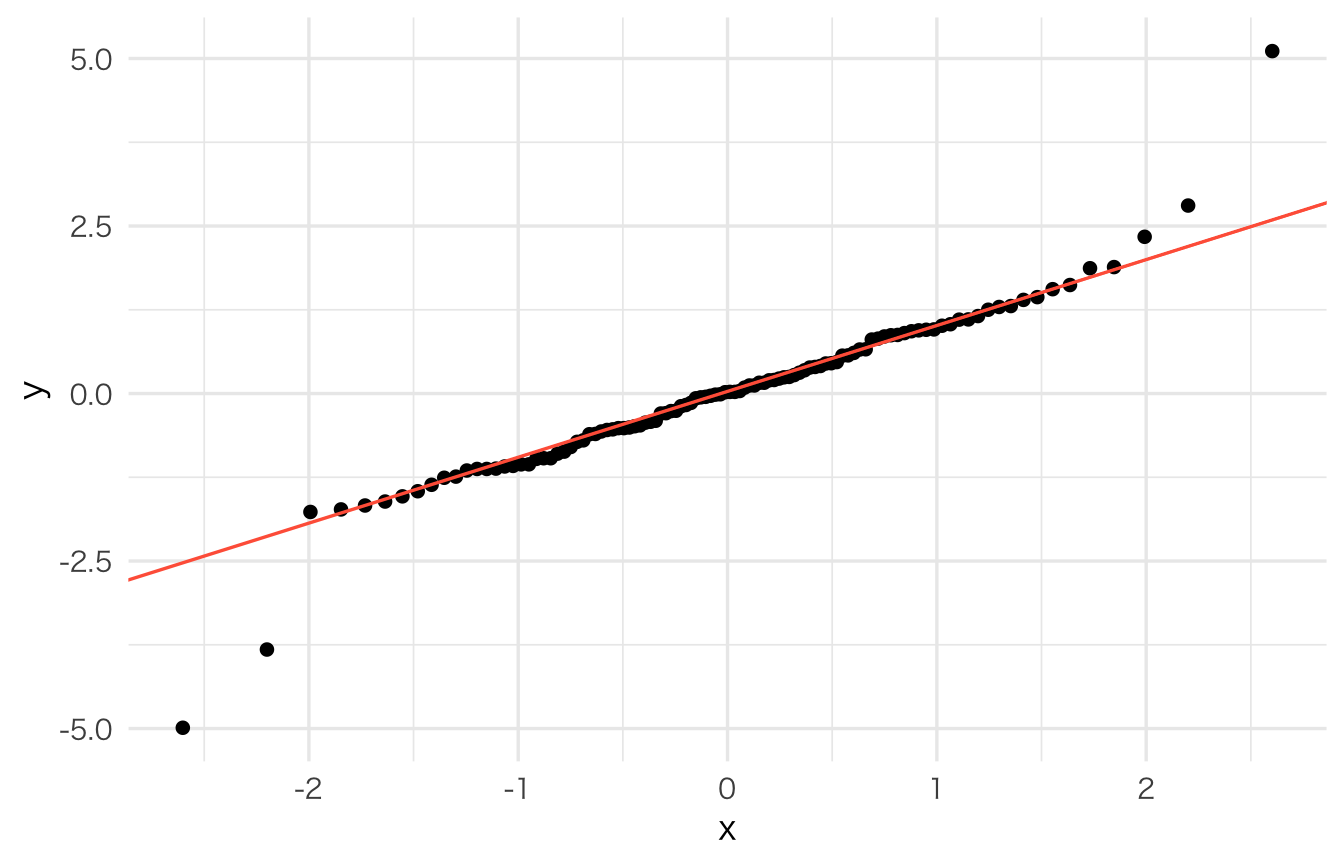ここまでの内容を、新しいデータで自分で試してみましょう。解答は折りたたんであります。まず自分で書いてから 開いてください。
データ:子どもの歯の成長 (Orthodont)
nlme パッケージ(R に標準で入っています)のデータです。27 人の子ども(男子 16 人、女子 11 人)について、8, 10, 12, 14 歳の時点で、下垂体から翼上顎裂までの距離 (mm) を測りました。
data(Orthodont, package = "nlme")
ortho <- as.data.frame(Orthodont)
ortho$Subject <- factor(as.character(ortho$Subject))
head(ortho)
  distance age Subject  Sex
1     26.0   8     M01 Male
2     25.0  10     M01 Male
3     29.0  12     M01 Male
4     31.0  14     M01 Male
5     21.5   8     M02 Male
6     22.5  10     M02 Male
distance:距離 (mm) ← 目的変数age:年齢 (8, 10, 12, 14)Subject:子どもの ID ← グループSex:性別 (Male / Female)
問1:可視化
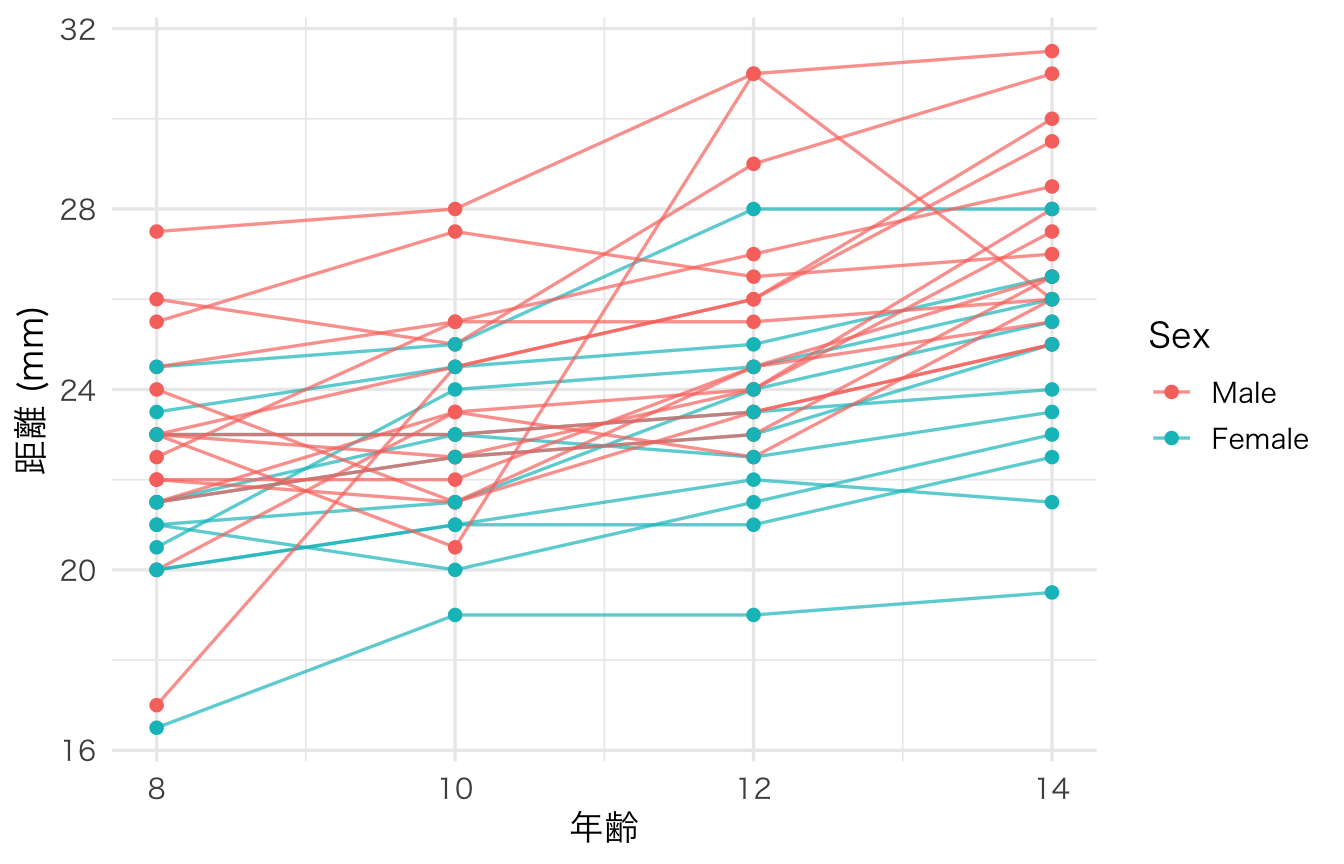
子どもごとに age と distance の関係を折れ線で描き、性別で色分けしてください。どんな傾向が見えますか?
ggplot(ortho, aes(age, distance, group = Subject, colour = Sex)) +
  geom_line(alpha = 0.7) + geom_point() +
  labs(x = "年齢", y = "距離 (mm)")
- 年齢とともに距離は伸びる
- 子どもによってスタートの高さが違う(ランダム切片が必要そう)
- 男子のほうが全体的に大きく、伸びも大きそう
問2:ランダム切片モデル
distance ~ age に子どもごとのランダム切片を加えたモデルを当てはめ、
- 1 歳あたりの成長量
- 子ども間のばらつき (SD) と残差 SD
- ICC
を求めてください。
m1 <- lmer(distance ~ age + (1 | Subject), data = ortho)
summary(m1)
Linear mixed model fit by REML. t-tests use Satterthwaite's method [
lmerModLmerTest]
Formula: distance ~ age + (1 | Subject)
   Data: ortho

REML criterion at convergence: 447

Scaled residuals:
    Min      1Q  Median      3Q     Max
-3.6645 -0.5351 -0.0129  0.4874  3.7218

Random effects:
 Groups   Name        Variance Std.Dev.
 Subject  (Intercept) 4.472    2.115
 Residual             2.049    1.432
Number of obs: 108, groups:  Subject, 27

Fixed effects:
             Estimate Std. Error        df t value Pr(>|t|)
(Intercept)  16.76111    0.80240 105.02536   20.89   <2e-16 ***
age           0.66019    0.06161  80.00000   10.72   <2e-16 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Correlation of Fixed Effects:
    (Intr)
age -0.845
vc <- as.data.frame(VarCorr(m1))
icc <- vc$vcov[1] / sum(vc$vcov)
icc
- 1 歳あたり約 0.66 mm 成長
- 子ども間 SD ≈ 2.11、残差 SD ≈ 1.43
- ICC ≈ 0.69。ばらつきの大部分が子ども間の違いによる
問3:年齢の中心化
問2のモデルの切片は「0 歳のときの距離」で、データの範囲外なので解釈できません。 age から 8 を引いた変数 age8 を作り、切片が「8 歳のときの平均的な距離」になるようにモデルを当てはめ直してください。傾きの推定値は変わりますか?
ortho$age8 <- ortho$age - 8
m1c <- lmer(distance ~ age8 + (1 | Subject), data = ortho)
rbind(元のモデル = fixef(m1), 中心化 = fixef(m1c))
           (Intercept)       age
元のモデル    16.76111 0.6601852
中心化        22.04259 0.6601852
傾きは変わらず、切片だけが「8 歳時点の値」に変わる。
問4:ランダム傾きモデル
age8 の傾きも子どもごとにばらつくモデル m2 を当てはめ、問3のモデル m1c と比較してください。ランダム傾きは必要ですか?
m2 <- lmer(distance ~ age8 + (age8 | Subject), data = ortho)
VarCorr(m2)
 Groups   Name        Std.Dev. Corr
 Subject  (Intercept) 1.88663
          age8        0.22643  0.209
 Residual             1.31004
anova(m1c, m2, refit = FALSE)
Data: ortho
Models:
m1c: distance ~ age8 + (1 | Subject)
m2: distance ~ age8 + (age8 | Subject)
    npar    AIC    BIC  logLik -2*log(L)  Chisq Df Pr(>Chisq)
m1c    4 455.00 465.73 -223.50    447.00
m2     6 454.64 470.73 -221.32    442.64 4.3658  2     0.1127
固定効果は同じなので REML のまま比較(refit = FALSE)。 p 値と AIC を見て判断する。p 値が 0.05 前後なら、境界の問題(第 チャプター 6 章)で p 値は保守的であることも考慮する。このデータでは傾きの個人差は小さめで、 どちらのモデルを選んでも固定効果の結論はほぼ変わらない。
問5:性別の効果
成長の仕方に男女差があるかを調べます。
Sex と age8:Sex(交互作用)を固定効果に加えたモデル m3 を作ってください(ランダム効果は (1 | Subject) で OK)- 交互作用なしのモデル
m3a と尤度比検定で比較してください
- 結果を言葉で説明してください
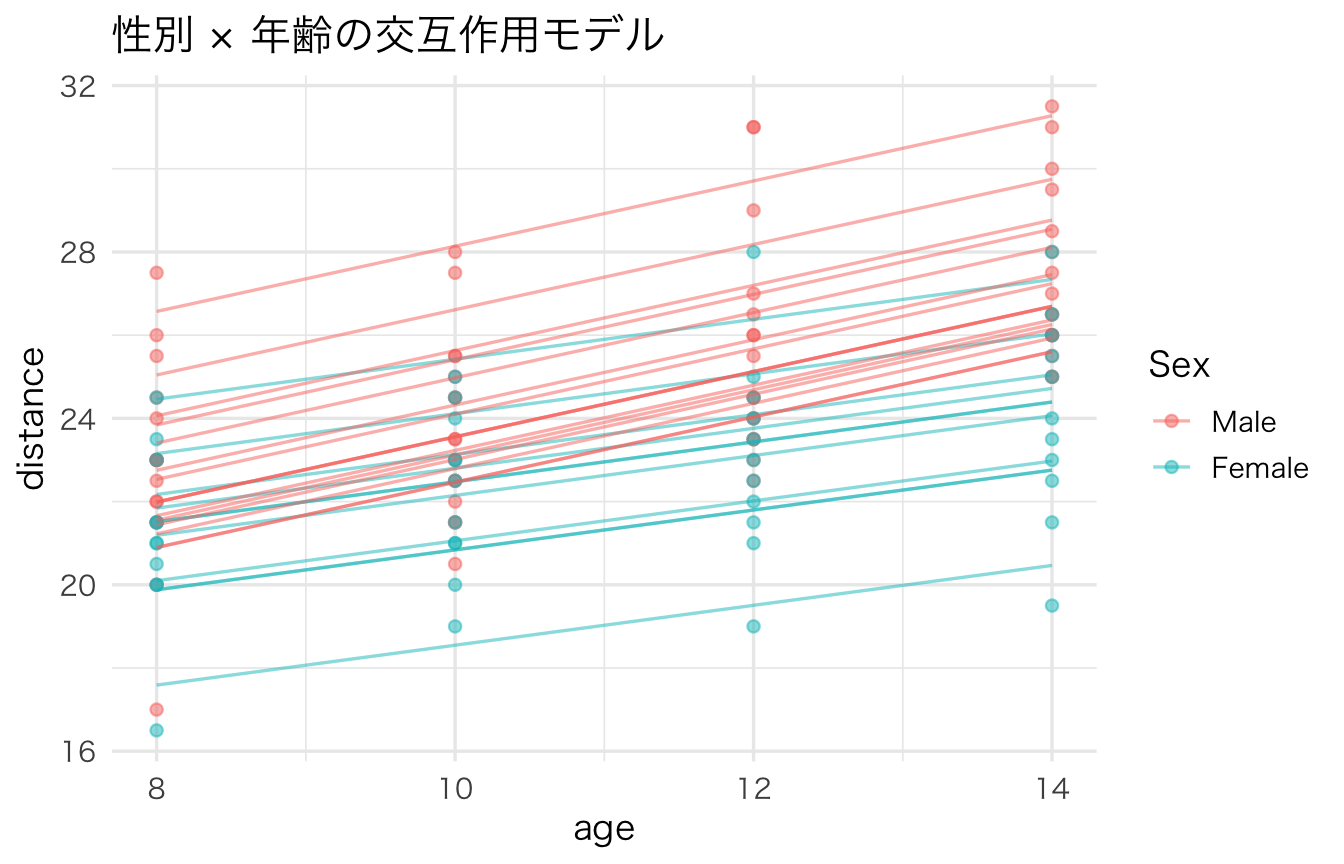
m3  <- lmer(distance ~ age8 * Sex + (1 | Subject), data = ortho)
m3a <- lmer(distance ~ age8 + Sex + (1 | Subject), data = ortho)
summary(m3)$coefficients
                 Estimate Std. Error      df   t value     Pr(>|t|)
(Intercept)    22.6156250  0.5387528 37.1373 41.977744 6.682335e-33
age8            0.7843750  0.0775011 79.0000 10.120823 6.441815e-16
SexFemale      -1.4065341  0.8440633 37.1373 -1.666385 1.040507e-01
age8:SexFemale -0.3048295  0.1214209 79.0000 -2.510520 1.409745e-02
anova(m3a, m3) # 固定効果が異なるので ML で再推定される
Data: ortho
Models:
m3a: distance ~ age8 + Sex + (1 | Subject)
m3: distance ~ age8 * Sex + (1 | Subject)
    npar    AIC    BIC  logLik -2*log(L)  Chisq Df Pr(>Chisq)
m3a    5 444.86 458.27 -217.43    434.86
m3     6 440.64 456.73 -214.32    428.64 6.2174  1    0.01265 *
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
- 基準カテゴリは
Male(levels(ortho$Sex) で確認)。
(Intercept):8 歳男子の平均的な距離age8:男子の 1 歳あたりの成長量SexFemale:8 歳時点での女子 − 男子 の差age8:SexFemale:成長量の差(女子 − 男子)。負なら女子のほうが成長が緩やか
尤度比検定の p 値が小さければ「成長の速さに男女差がある」と言える。
ortho$pred <- predict(m3)
ggplot(ortho, aes(age, distance, colour = Sex)) +
  geom_point(alpha = 0.5) +
  geom_line(aes(y = pred, group = Subject), alpha = 0.5) +
  labs(title = "性別 × 年齢の交互作用モデル")
問6:診断
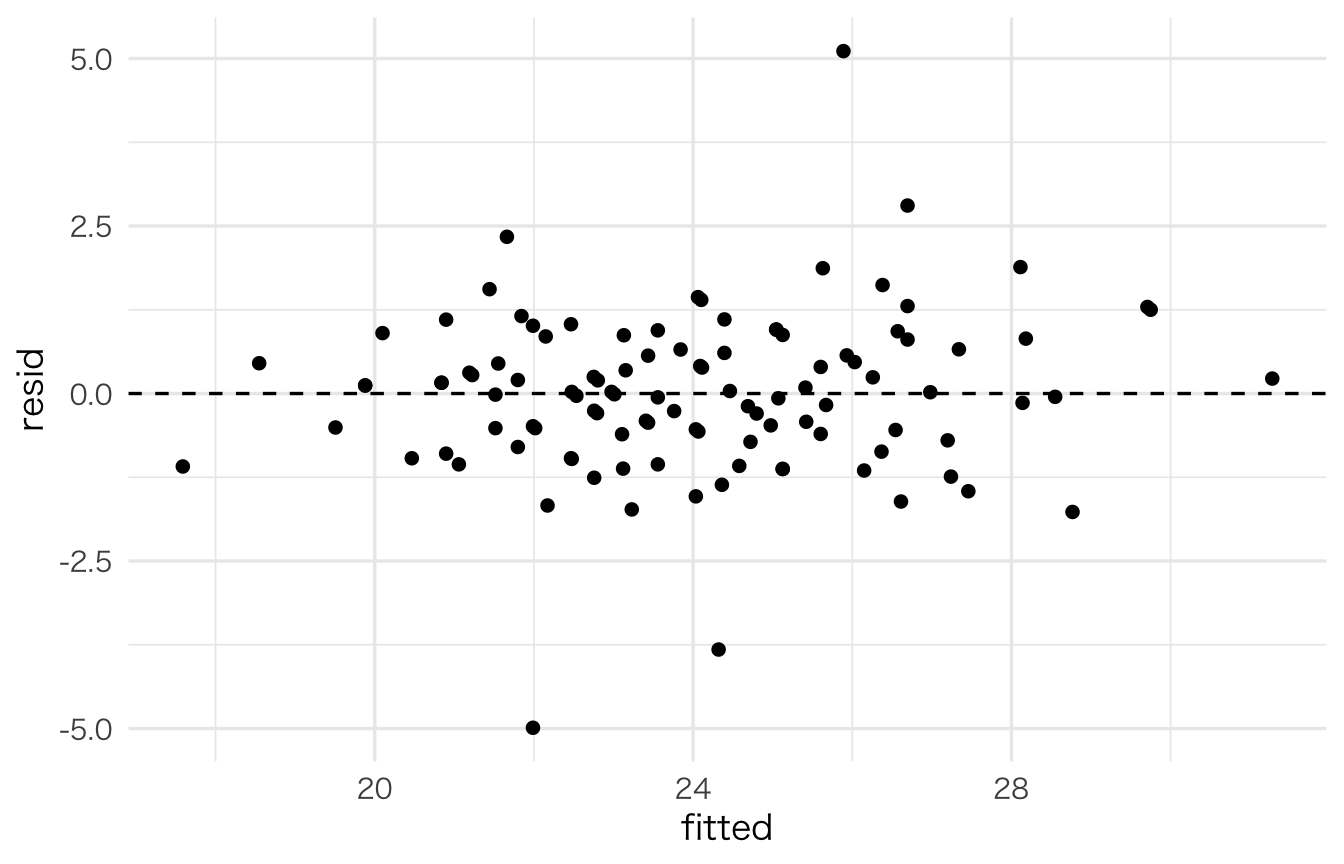
問5のモデル m3 について、残差 vs 予測値プロットと残差の Q-Q プロットを描き、問題がないか確認してください。
dd <- data.frame(fitted = fitted(m3), resid = resid(m3), Subject = ortho$Subject)

ggplot(dd, aes(fitted, resid)) +
  geom_point() + geom_hline(yintercept = 0, linetype = 2)
ggplot(dd, aes(sample = resid)) + stat_qq() + stat_qq_line(colour = "tomato")
# 残差が特に大きい観測を確認
ortho[order(-abs(resid(m3)))[1:4], c("Subject", "age", "distance", "Sex")]
   Subject age distance  Sex
35     M09  12     31.0 Male
49     M13   8     17.0 Male
34     M09  10     20.5 Male
52     M13  14     29.5 Male
このデータでは一部の子ども(例:M09, M13)の測定値に大きめの残差が見られる。 外れ値の可能性を検討し、除いた場合に結論が変わるか(感度分析)を確かめるとよい。
発展問題
- 第 チャプター 1 章のシミュレーションで、学校数を 20 → 6 に減らすと
lmer の偽陽性率はどうなるか?(グループ数が少ないときの注意点)
sim_school() を改造して、学校ごとに傾きも違うデータを作り、ランダム傾きモデルで真の値を復元できるか確かめよう。sleepstudy で Days を 0〜1 日目(訓練期間)と 2 日目以降に分けて分析してみよう(実はこのデータの睡眠制限は 2 日目から始まっている)。
お疲れさまでした!