# 診断と結果の報告 {#sec-diagnostics}
```{r}
#| echo: false
source("R/setup.R")
data(sleepstudy)
fit_rs <- lmer(Reaction ~ Days + (Days | Subject), data = sleepstudy)
```
## モデルの仮定をチェックする
線形混合モデルの主な仮定は次のとおりです。
1. 固定効果の部分が **線形**
2. 残差 $\varepsilon_{ij}$ が正規分布、分散が一定
3. ランダム効果 $u_j$ が正規分布
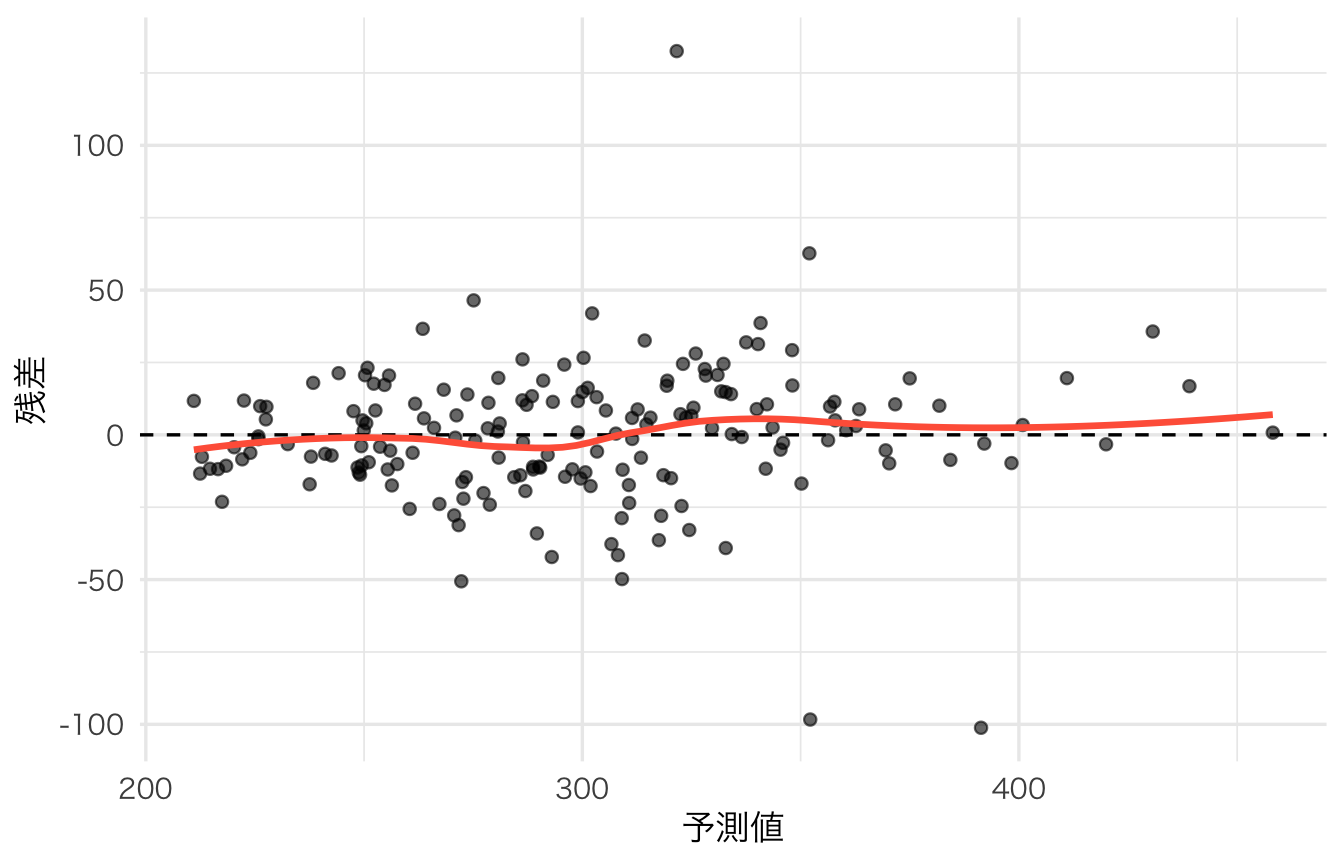
### 残差 vs 予測値
```{r}
diag_df <- data.frame(fitted = fitted(fit_rs), resid = resid(fit_rs))

ggplot(diag_df, aes(fitted, resid)) +
  geom_point(alpha = 0.6) +
  geom_hline(yintercept = 0, linetype = 2) +
  geom_smooth(se = FALSE, colour = "tomato") +
  labs(x = "予測値", y = "残差")
```
- 残差が 0 のまわりに **均等に** 散らばっていれば OK
- ラッパ型(右に行くほど広がる)→ 分散が一定でない。目的変数の対数変換などを検討
- 曲線のパターン → 線形でない関係がある。2 次の項などを検討
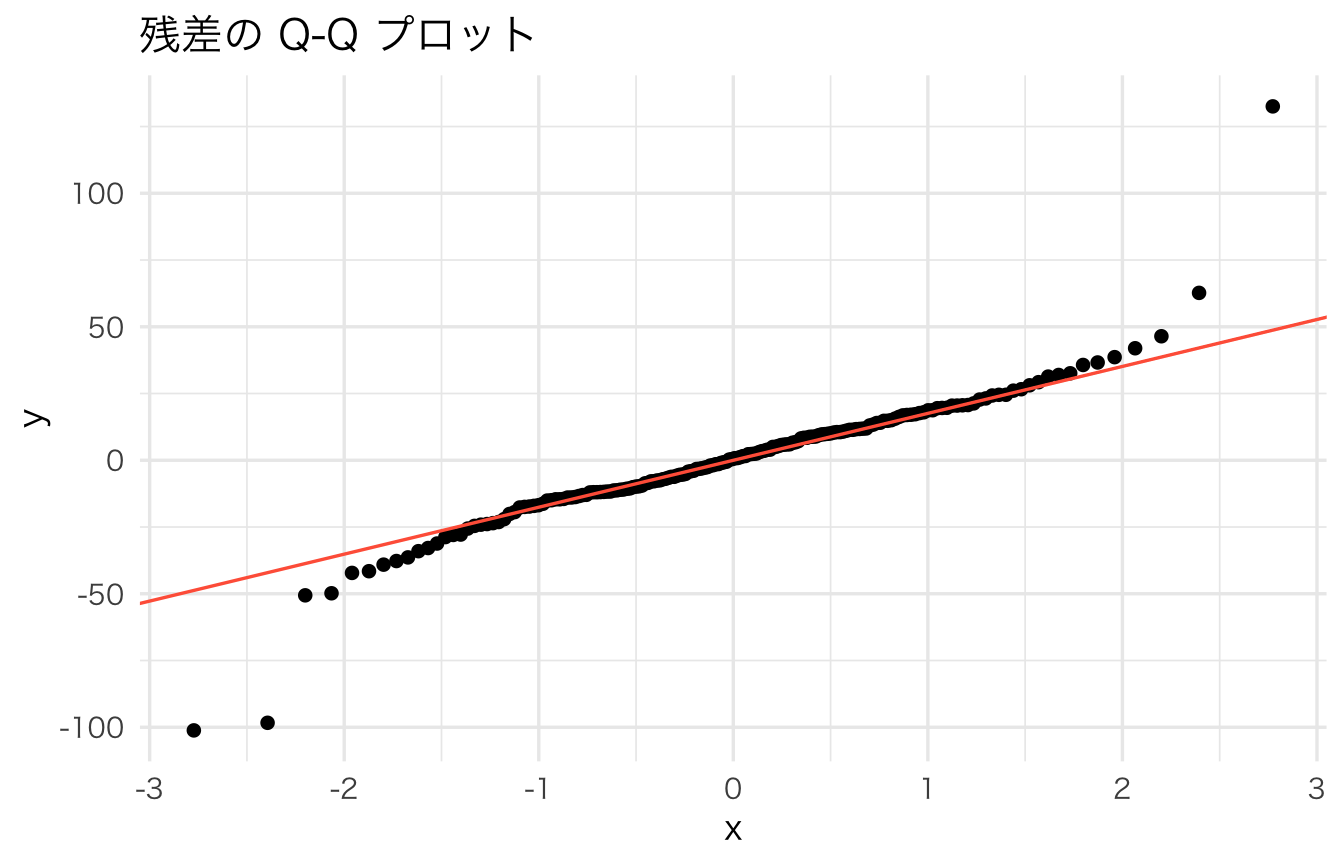
### 残差の正規 Q-Q プロット
```{r}
ggplot(diag_df, aes(sample = resid)) +
  stat_qq() + stat_qq_line(colour = "tomato") +
  labs(title = "残差の Q-Q プロット")
```
点がおおむね直線上に並べば正規分布の仮定は妥当です。両端が少し外れるのはよくあることです。
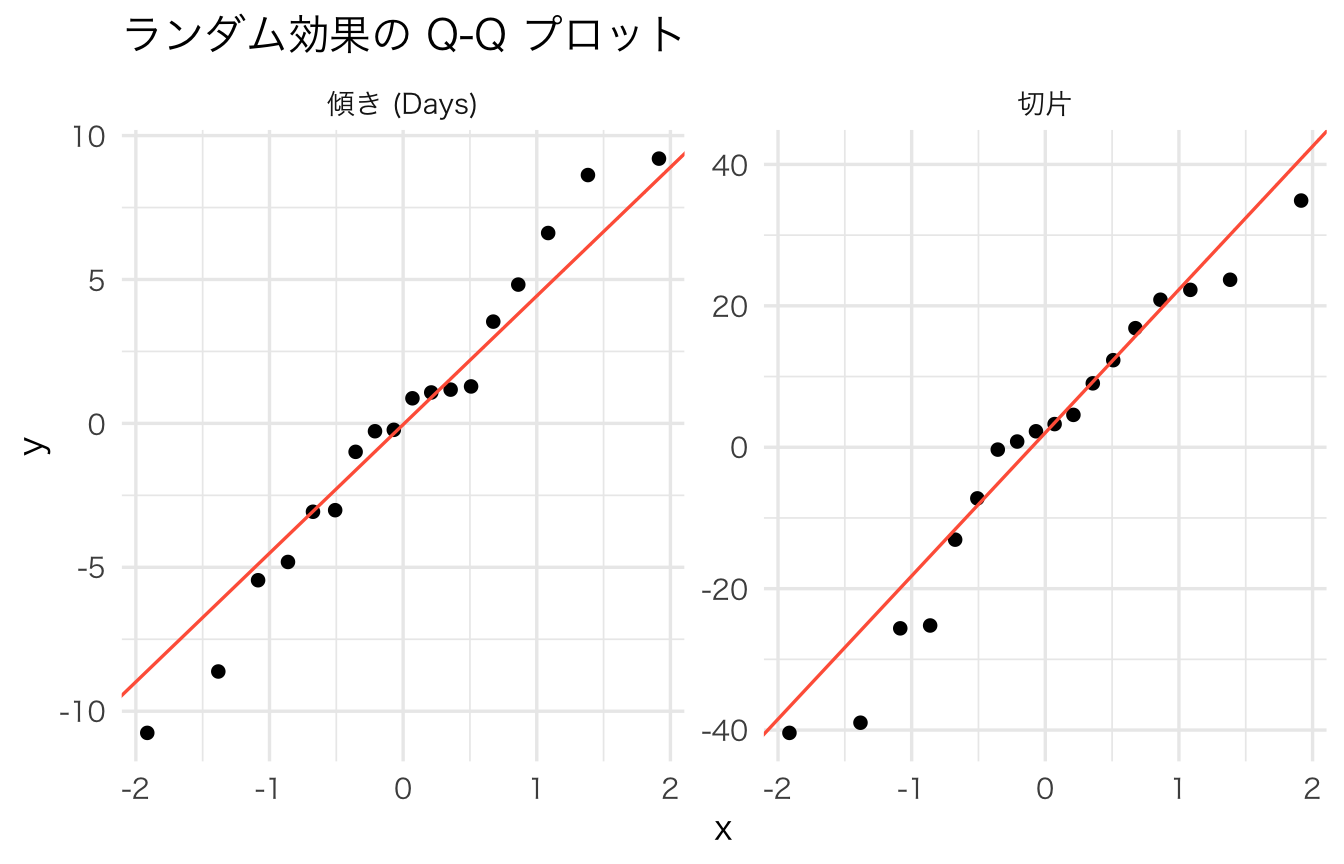
### ランダム効果の Q-Q プロット
```{r}
re <- ranef(fit_rs)$Subject
re_long <- data.frame(value = c(re[, 1], re[, 2]),
                      term  = rep(c("切片", "傾き (Days)"), each = nrow(re)))

ggplot(re_long, aes(sample = value)) +
  stat_qq() + stat_qq_line(colour = "tomato") +
  facet_wrap(~ term, scales = "free") +
  labs(title = "ランダム効果の Q-Q プロット")
```
グループ数(ここでは 18 人)が少ないと判断は難しいですが、極端な外れ値がないかを確認します。
::: {.callout-tip}
**performance** パッケージの `check_model(fit)` を使うと、これらの診断図をまとめて描けます(`install.packages("performance")`)。
:::
## よく出る警告とその対処
### `boundary (singular) fit: see help('isSingular')`
ランダム効果の分散が **0 と推定された**、または相関が ±1 と推定されたときに出ます。
```{r}
#| warning: true
#| message: true
set.seed(3)
g <- factor(rep(1:10, each = 5))
x <- runif(50)
y <- 1 + 2 * x + rnorm(50)          # 実はグループ差がないデータ
fit_sing <- lmer(y ~ x + (1 | g))
VarCorr(fit_sing)
isSingular(fit_sing)
```
主な原因と対処:
- 本当にグループ間のばらつきがほとんどない → そのランダム効果を外す(外しても結果はほぼ同じ)
- ランダム効果の構造がデータに対して複雑すぎる → `(x | g)` を `(x || g)` や `(1 | g)` に簡略化
- グループ数が少なすぎる
### `Model failed to converge`
最適化(パラメータ探し)がうまく収束しなかったときに出ます。
- 説明変数の **スケールをそろえる**(中心化・標準化):`scale(x)` など
- 最適化アルゴリズムを変える:`lmer(..., control = lmerControl(optimizer = "bobyqa"))`
- `allFit(fit)` で複数のアルゴリズムを試し、結果が一致するか確認する
- ランダム効果の構造を簡略化する
::: {.callout-note}
## 中心化(センタリング)のすすめ
切片は「説明変数がすべて 0 のときの値」です。年齢や身長など 0 に意味がない変数は、
平均を引いておく(`x_c = x - mean(x)`)と、切片が「平均的な x のときの値」になり解釈しやすく、
切片と傾きの相関も小さくなって推定が安定します。
:::
## 結果の報告
論文やレポートには、最低限次の情報を書きます。
1. **モデルの構造**:目的変数、固定効果、ランダム効果、グループ
2. **推定方法とソフトウェア**:REML / ML、R と lme4 のバージョン、p 値の計算方法
3. **固定効果**:推定値、標準誤差(または 95% 信頼区間)、検定結果
4. **ランダム効果**:各 SD(または分散)、相関
```{r}
ci <- confint(fit_rs, parm = "beta_", method = "Wald")
fe <- summary(fit_rs)$coefficients
vc <- as.data.frame(VarCorr(fit_rs))

fe_tab <- data.frame(
  推定値 = round(fe[, "Estimate"], 2),
  SE     = round(fe[, "Std. Error"], 2),
  `95%CI` = sprintf("[%.2f, %.2f]", ci[, 1], ci[, 2]),
  df     = round(fe[, "df"], 1),
  t      = round(fe[, "t value"], 2),
  p      = format.pval(fe[, "Pr(>|t|)"], digits = 2, eps = 0.001),
  check.names = FALSE
)
knitr::kable(fe_tab, caption = "固定効果")
knitr::kable(
  data.frame(グループ = vc$grp, 項 = ifelse(is.na(vc$var2), vc$var1, paste(vc$var1, "×", vc$var2)),
             `SD / 相関` = round(vc$sdcor, 2), check.names = FALSE),
  caption = "ランダム効果"
)
```
### 報告文の例
> 反応時間を目的変数、睡眠制限日数を固定効果、被験者ごとの切片と日数の傾きをランダム効果(相関あり)とする線形混合モデルを、R (`r getRversion()`) の lme4 パッケージ (`r packageVersion("lme4")`) を用いて REML 法で推定した。固定効果の検定には lmerTest パッケージによる Satterthwaite 近似を用いた。
> 睡眠制限 1 日あたり反応時間は平均 `r sprintf("%.1f", fe["Days", "Estimate"])` ms 増加した(95% CI [`r sprintf("%.1f", ci["Days", 1])`, `r sprintf("%.1f", ci["Days", 2])`], *t*(`r sprintf("%.1f", fe["Days", "df"])`) = `r sprintf("%.2f", fe["Days", "t value"])`, *p* < .001)。傾きの個人差の SD は `r sprintf("%.1f", vc$sdcor[2])` ms/日 であった。
## 次のステップ
- **一般化線形混合モデル (GLMM)**:目的変数が 0/1(合否)やカウント(件数)のとき。`lme4::glmer(y ~ x + (1 | g), family = binomial)` など
- **ベイズ推定**:`brms` パッケージ。複雑なモデルでも収束しやすく、不確実性をそのまま扱える
- **参考書**
- 久保拓弥『データ解析のための統計モデリング入門』(岩波書店)— GLM から GLMM、ベイズへ
- Gelman & Hill "Data Analysis Using Regression and Multilevel/Hierarchical Models"
- Bates et al. (2015) "Fitting Linear Mixed-Effects Models Using lme4", *Journal of Statistical Software* 67(1)
::: {.callout-important}
## この章のまとめ
- 残差プロット、Q-Q プロットで仮定をチェック
- singular fit → ランダム効果の簡略化を検討。収束しない → スケーリング・最適化手法の変更
- 報告には「モデル構造・推定法・固定効果・ランダム効果」をセットで書く
:::